基于DataWorks构建数据中台数据服务 从规划到落地的完整指南
引言
在数字化转型浪潮中,数据中台已成为企业打破数据孤岛、实现数据资产化、赋能业务创新的核心基础设施。而数据服务作为数据中台对外输出价值的关键“窗口”,直接决定了数据能否被高效、安全、便捷地消费。阿里云DataWorks作为一站式大数据开发治理平台,提供了从数据集成、开发、治理到数据服务的全链路能力。本文将系统阐述如何基于DataWorks构建数据中台的数据服务体系,涵盖架构设计、实施步骤、关键技术及最佳实践。
一、数据中台数据服务的核心定位与需求
数据服务并非简单的API包装,而是数据中台能力的产品化输出。其核心需求包括:
- 统一服务出口:将分散在数仓、数据库、文件中的数据结构化、标准化后,以API形式统一暴露。
- 高效查询性能:支持高并发、低延迟的数据查询,满足在线业务实时调用。
- 安全与权限管控:实现字段级、行级权限控制,确保数据不越权访问。
- 服务生命周期管理:覆盖API的创建、测试、发布、下线、监控全流程。
- 多协议适配:支持RESTful、WebSocket、HSF等多种协议,适配不同消费端。
DataWorks的数据服务(DataService Studio)正是为满足这些需求而设计,它基于MaxCompute、Hologres、ADB等计算引擎,提供百万级QPS的高性能API网关。
二、基于DataWorks的数据服务总体架构
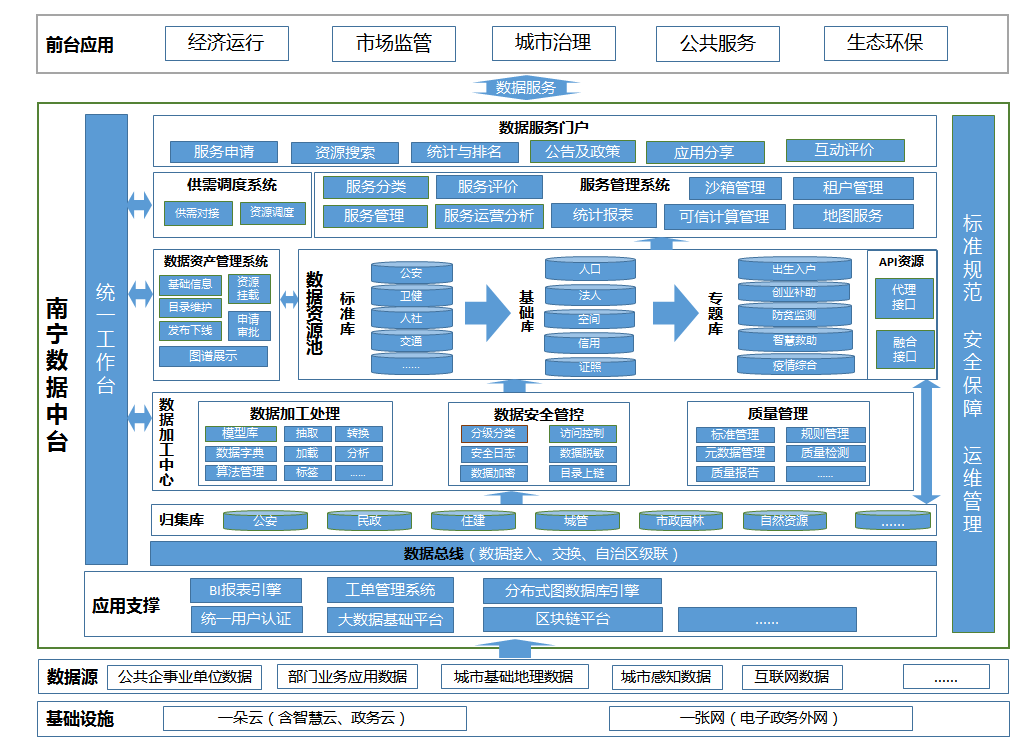
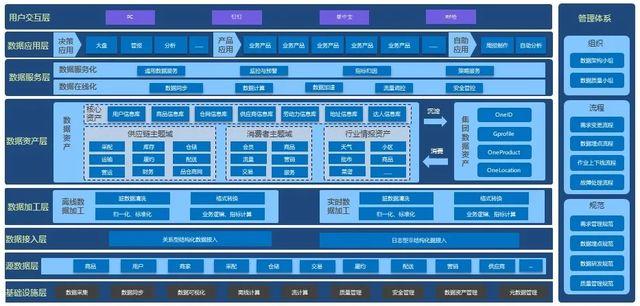
推荐采用分层架构:
- 数据源层:包括MaxCompute数仓表、Hologres实时数仓、RDS业务库、OSS文件等。
- 数据准备层:在DataWorks中通过数据集成、数据开发(ODPS SQL、PyODPS)完成数据清洗、聚合、宽表构建,形成面向服务的“服务化数据层”。
- 数据服务层:利用DataWorks数据服务功能,将服务化数据表注册为API,并配置参数、返回字段、缓存、限流等策略。
”- 网关层:API网关负责鉴权、流控、协议转换、日志记录。
- 消费层:内部应用、合作伙伴、大屏、移动端等通过API获取数据。
三、实施步骤详解
3.1 数据准备:构建服务化数据层
数据服务的性能与稳定性高度依赖底层数据模型。建议:
- 在MaxCompute或Hologres中创建服务化宽表,按查询维度(如用户ID、商品ID、时间)进行分区和聚簇。
- 利用DataWorks数据集成将多源数据同步至数仓,通过SQL进行ETL加工。
- 对于实时性要求高的场景,采用Hologres作为服务化存储,利用其行列共存、高并发点查能力。
- 示例:构建“用户画像服务表”,包含用户基础信息、标签、实时行为汇总,按user_id分片。
3.2 数据服务API开发
进入DataWorks数据服务控制台:
- 创建API:选择“生成API”模式,向导式配置。
- 选择数据源(如Hologres)、表名,系统自动解析字段。
- 设置请求参数(可选):如userid、pagesize等,支持常量、累加、枚举等类型。
- 设置返回参数:选择需返回的字段,支持字段别名、脱敏、格式化。
- 配置高级选项:缓存时长、超时时间、限流阈值(QPS)、HTTPS支持。
- 自定义SQL模式:对于复杂查询,可直接编写SQL并绑定参数,灵活度高。
- 注册外部API:遗留系统接口可通过注册方式纳管,实现统一管理。
- 测试与发布:在开发环境测试通过后,发布至生产环境,支持版本管理。
3.3 安全与权限管控
- 认证授权:集成阿里云RAM,为不同应用分配AK(AccessKey),并按API授权。
- 字段级权限:在数据服务中配置敏感字段的脱敏规则(如手机号掩码)。
- 行级权限:通过参数注入或自定义SQL中的变量(如${tenant_id})实现租户数据隔离。
- 网络隔离:使用VPC内网访问,或通过API网关的公网/内网域名控制流量。
3.4 服务运维与监控
- 监控大盘:DataWorks数据服务提供API调用次数、成功率、响应时间、QPS等指标,可配置告警。
- 日志分析:所有调用日志自动推送至SLS,便于审计与问题排查。
- 限流与熔断:按API或应用维度设置流控策略,防止过载。
- 版本管理:支持API版本迭代与灰度发布,保障业务连续性。
3.5 网关集成与消费
- 数据服务发布的API可自动同步至阿里云API网关,实现更强大的插件能力(如JWT鉴权、IP黑白名单)。
- 生成SDK:支持Java、Python等多种语言,方便应用快速集成。
- 文档中心:自动生成API文档,降低协作成本。
四、性能优化与最佳实践
- 存储选型:高并发点查场景优先选用Hologres;批量分析场景可用MaxCompute + 数据服务(通过MCQA加速)。
- 索引设计:在服务化表中为查询条件字段建立索引,Hologres中可设置聚集索引、二级索引。
- 结果缓存:对变化频率低的API开启缓存,可大幅降低后端压力。
- 异步化:对耗时长的查询,提供异步API,返回任务ID后再轮询结果。
- 数据服务用量控制:合理设置QPS上限,避免个别应用占用过多资源。
- 统一数据标准:服务化层的表命名、字段命名、单位应遵循企业数据标准,确保API易理解、易复用。
五、典型案例:零售企业数据服务中台
某零售企业基于DataWorks构建数据中台,数据服务落地场景如下:
- 商品详情服务:基于Hologres宽表,提供商品标题、价格、库存、评价等API,QPS峰值8万,平均响应时间20ms。
- 会员标签服务:从MaxCompute标签表生成API,支持按会员ID查询标签列表,用于精准营销。
- 实时交易查询:利用Hologres实时写入能力,通过API提供用户近30天订单查询,替代了原有昂贵的数据库直连。
实施后,数据接口开发效率提升70%,业务部门自助取数比例提升至60%,数据安全事件为零。
六、与展望
基于DataWorks构建数据中台数据服务,不仅能快速实现数据的API化输出,还与数据开发、治理流程无缝衔接,形成“开发-治理-服务”闭环。随着Data Fabric、Data Mesh理念的兴起,数据服务将更加智能化、自助化。建议企业在建设初期就明确服务分层、安全策略与运维规范,并持续迭代服务目录,让数据中台真正成为业务增长的引擎。
通过以上步骤与最佳实践,您可以基于DataWorks搭建起一套高性能、安全、易用的数据服务中台,为企业的数字化应用提供坚实的API基石。
如若转载,请注明出处:http://www.kuaizijinrong.com/product/48.html
更新时间:2026-10-27 20:08:34